
Wie kann man sicherstellen, dass DAX Measures, die man mit KI generiert hat - wie z.B. mit Copilot, Claude Code, ChatGPT etc. - korrekte Daten zurückgeben?
DAX ist eine anspruchsvolle Sprache und nicht jedermanns Sache. Daher gibt es diverse Wege, um funktionierenden DAX-Code für die Measures zu erstellen:
- Man schaut sich ein Video an, kopiert und adaptiert den Code und hofft, dass die richtigen Daten zurückgeben werden
- Man ruft den DAX-Editor in Power BI auf und läßt sich von Copilot beraten
- Das Überprüfen findet statt, indem man das neue Measure in einem Bericht ausprobiert und ein wenig herumklickt. Ev. fragt man auch einen Kollegen, der auch ein wenig klickt …
Über die Frage, wie man denn auf professionelle Weise zu einem Ergebnis kommt, könnte diskutiert werden. Wenn jemand die Sprache DAX beherrscht, ist dieser Weg klar: auf Grund von Wissen wird korrekter Code erstellt. Jedoch sind auch Shortcuts wie die Verwendung von Copilot legitim, Hauptsache, das Ergebnis stimmt. Wie kann jedoch sicher gestellt werden, dass das Ergebnis tatsächlich richtig ist? Und die zweite Frage: wenn ein Measure als korrekt verifiziert wurde, wie stellt man sicher, dass die nächste Version eines Measures nach einer Änderung immer noch korrekt ist?
In der Softwareentwicklung gibt es Testing schon lange, es ist ein Haufen von Konzepten, um die Richtigkeit von Code durch automatische Verfahren zu belegen. Tests für DAX Measures können in drei Situationen eingesetzt werden: 1. Tests werden angewandt, um sich während der Entwicklung dem korrekten Code anzunähern. 2. Tests können auch verwendet werden, wenn DAX Code geändert wurde. Am Besten werden Tests in die Prozesse integriert, die Änderungen in das semantische Modell übertragen (CI/CD). 3. Durch die Möglichkeiten, DAX Code mit Hilfe von KI wie Copilot, Claude Code etc. generieren zu lassen, entsteht ein weiterer Einsatzzweck: Tests sind im Rahmen von KI-basierter Entwicklung Features, um dem KI-Generator ein Feedback zu geben. Anhand der Tests kann der Generator feststellen, ob das anvisierte Ziel erreicht wurde. Die Annäherung an den korrekten Code kann automatisch in Schleifen erfolgen, bis das durch den Test vorgegebene Ergebnis tatsächlich erreicht wurde.
Testing mit Vibe Coding? Die Verwendung von menschlicher Sprache für die Festlegung von Zielen bzw. zu erreichenden Werten, die Verwendung von MarkDown-Dateien, um das Ziel textual zu beschreiben etc. können grundsätzlich nur schwer ein Ersatz für einen richtigen Test sein. Der Bereich der Berichtsdaten-Entwicklung unterscheidet sich in einem wichtigen Punkt von der restlichen Softwareentwicklung: Häufig wird in diesem Bereich nicht erwartet, dass die Daten einen guten Eindruck machen, wahrscheinlich richtig sind oder dergleichen. Sondern es wird i.d.R. erwartet, dass die Daten bis in die zweite Nachkommastelle hinein korrekt sind. Um das Ziel zu beschreiben - also wie die korrekten Daten aussehen sollen -, müssen diese Daten also hardcodiert werden, in der Form von Listen, CSV-Dateien, DataSets etc. Und es braucht eine Logik dazu: es muss Testroutinen geben, die Tests ausführen, Algorithmen und Daten zusammenbringen und ermitteln, ob das erwartete Ergebnis erreicht wurde. Letztlich können hardcodierte Tests nur von Menschen erstellt werden.
Doch wie sieht die Realität aus? Im Berichtswesen ist es schon immer eher ein zweitrangiges Ziel gewesen, Daten und Algorithmen systematisch zu testen. Fehler werden normalerweise adhoc erkannt. Konkret bedeutet dies, dass Anwender, die sich mit der Fachlichkeit auskennen, Fehler mehr oder weniger zufällig entdecken, während sie gerade die Berichte nutzen. Dann wird ein Ticket in die Welt gesetzt; gerne mit der wenig aussagekräftigen Meldung die Daten stimmen nicht und ein langwieriger Rechercheprozess setzt sein, weil die Supporter die Fehlermeldung nicht verstehen oder den ganzen ETL-Stack inkl. der Persistenzschichten analysieren müssen. Im schlimmsten Fall kommt die Meldung ein Jahr später noch einmal auf und der ganze Rechercheprozess beginnt von vorn.
Durch SelfService BI verschärft sich dieses Problem. Häufig liegt die Aufgabe, Berichtsdaten zu erzeugen und Measures zu entwickeln, nicht mehr in der Hand einer BI Abteilung. Dadurch besteht die Gefahr, dass nicht mehr fundiertes Wissen die Grundlage für das Coding von Measures ist, sondern dass die Measures durch Modifizierung von Internet-Templates entstehen oder Generatoren die Measures erzeugen. Die Fälle, in denen dann nachgearbeitet werden muss, werden zunehmen. Das verursacht Kosten. Die Fälle, in denen Measures nicht mehr verstanden werden, ebenfalls. Das verursacht einen Verlust an Qualität.
Wie könnte eine Lösung aussehen? Zunächst kommt es darauf an, überhaupt Testing als notwendiges Feature in der Entwicklung von Berichten zu sehen - also unabhängig von der Frage, ob man Copilot verwendet oder nicht. Durch die Integration von Tests in die Entwicklung von Berichten und Measures würde man auch in einer klassisch organisierten BI für einen enormen Fortschritt sorgen! Und wenn dann dieser Schritt getan wurde, ist die Integration der Tests in die KI-basierten Generatoren ebenfalls möglich.
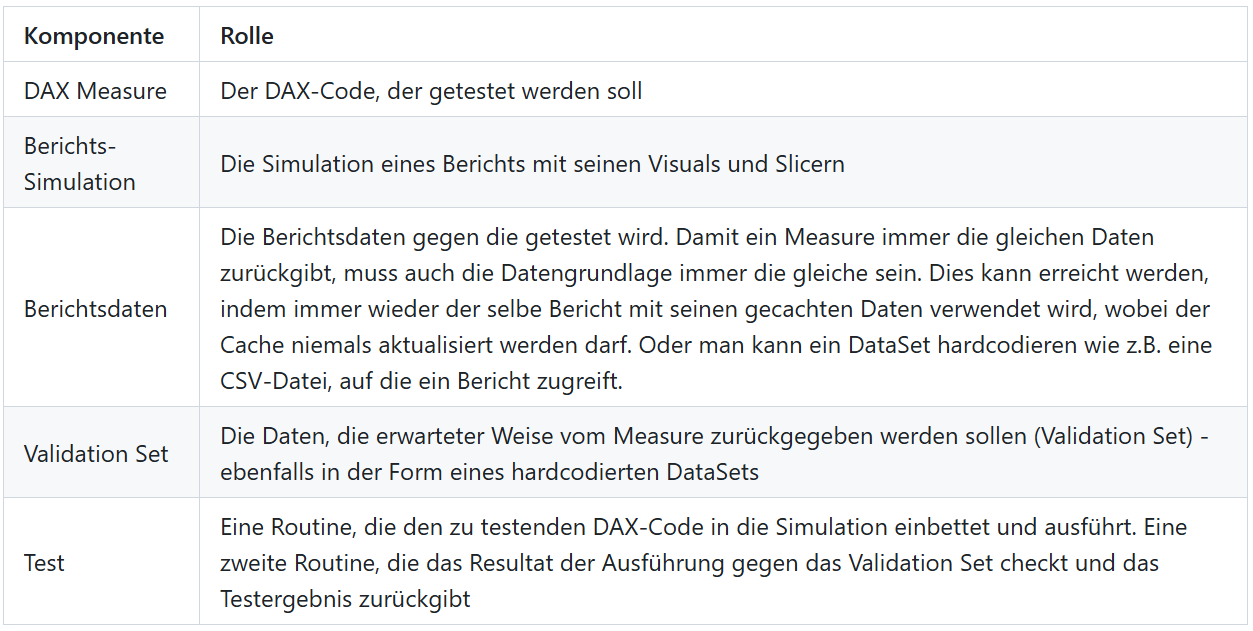
Ein Test für ein DAX-Measure besteht aus den folgenden Komponenten:
Beispiel
Jeder der oben erwähnten Schritte stellt technisch eine Herausforderung dar und soll an einem einfachen Beispiel dargestellt werden. Das Szenario sieht vor, für den aktuellen Monat einen Vergleich zur Vorperiode zu machen. Dabei sollen die Aggregate tagesgenau verglichen werden - also bis zum jeweiligen Tag. Da im Szenario das aktuelle Datum der 2025-06-06 ist, ergibt sich für den Monat des Vorjahrs entsprechend ein Rollup bis zum 2024-06-06.
Anders als im Beispiel wäre ein Periodenvergleich in der Realität ein sehr relevanter Fall und gut geeignet für Testing. Der Grund: gerade Periodenvergleiche werden schnell komplex. Beispielsweise müssen Feiertage berücksichtigt werden, Schichten, unterschiedliche Kalenderwochensysteme etc. Dafür können dann häufig keine vorgefertigten Funktionen verwendet werden. Eine Testroutine wäre sehr nützlich, die komplexen Algorithmen zu validieren.
Im meinem nachfolgenden Pseudocode-Beispiel habe ich aber die Komplexität eines praxisnahen Business Case weggelassen und einfach die Funktion SAMEPERIODLASTYEAR() benutzt. Es geht ja ums Testing, nicht um den DAX-Algorithmus.
DAX Measure. Code für das zu testende Measure:
string daxMeasure = @"
MEASURE FactSales01[PrevAmount] =
	CALCULATE(
		[Amount],
		ALL('Time'),
SAMEPERIODLASTYEAR('Time'[Date]))";Berichts-Simulation. Die meisten Visuals rufen im Hintergrund die Funktion SUMMARIZECOLUMNS auf. Und für Slicer kommt häufig die Funktion TREATAS zum Einsatz. Der folgende Code simuliert also einen Bericht, bei dem das Matrix Visual benutzt wird und der Anwender aus einer Liste von Jahren die beiden Elemente 2024 und 2025 per Klick ausgewählt hat:
string daxQuery = @"
DEFINE
	VAR _filterTime =
		TREATAS(
			{2024, 2025},
			'Time'[Year])
	MEASURE FactSales01[Amount] =
		CALCULATE(
			SUM(FactSales01[Amount]))
	MEASURE <measure_code>
EVALUATE(
	SUMMARIZECOLUMNS(
		'Time'[Month1],
		_filterTime,
		"CurrentAmount", [Amount],
<measure_name>, <measure_code>))";Berichtsdaten.
Z.B. Bericht Sales-Report.pbix mit CSV-Datei sales-data-20260606.csv.
Validation Set. Die Daten, die von einem Test zurückgegeben werden müssen, damit ein Test als erfolgreich angesehen wird:
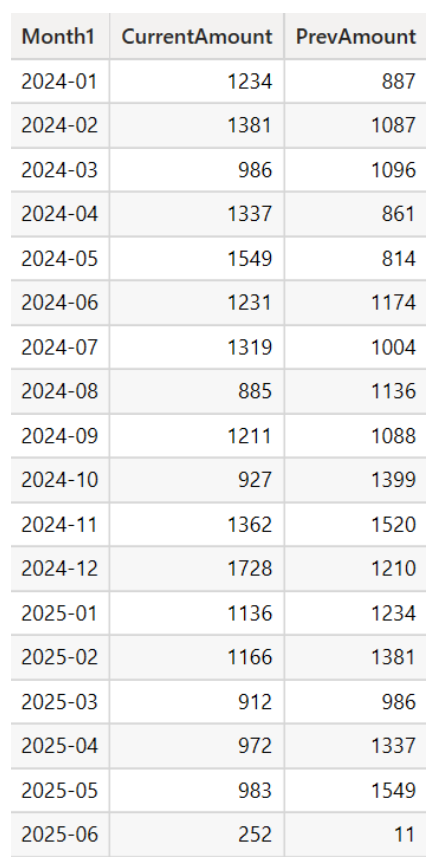
Test. Pseudocode für einen Test. Um Actual und Expected generisch vergleichen zu können, werden HashKeys auf den Ergebnissen berechnet:
string measureName = "PrevAmount";
string daxTest = daxQuery.Replace("<measure_name>", measureName);
daxTest = daxTest.Replace("<measure_code>", daxMeasure);
actual = HashKey(Dax.Query.Run(daxTest));
expected = HashKey(ValidationSet);

If(actual != expected) {
	... // Test failed
} Else {
	...
}