
In Tabularen Modellen - PowerBI und SSAS Tabular - kann zwischen Import Mode und Direct Query Mode gewählt werden. In den meisten Fällen ist zwar der Import Mode der besser geeignete, jedoch gibt es verschiedene Szenarien, in denen der Direct Query Mode die bessere Wahl ist:
- Präsentation von Daten in RealTime wie z.B. aktuelle Produktions-Daten, Trace-, Log- und Audit-Daten
- Zugriff auf Daten in einer hohen Granularität (Kassensysteme, Zutrittskontrolle, Maschinen-Daten im Allgemeinen)
- Datenmengen, die den Arbeitsspeicher des tabularen Clients überschreiten
Bei der Kombination von tabularen Client und Datenbank-Backend tauchen diverse Performance-Probleme auf, die
- sich nicht grundsätzlich vermeiden lassen
- deren konkrete Gründe spezifisch für die Umgebung sind (User-Interaktion, Berichts-Layout, Indizes auf Tabellen etc.)
- komplex sein können
Dieser Artikel beschreibt einen der vielen technischen Aspekte, die die Interaktion von Tabularen Client und DBMS betreffen, nämlich das Navigieren in einer grossen Datenmenge mittels Paging. Da Paging zu einem Performance-Problem werden kann, ist es gut, den potentiellen Gründen auf den Grund zu gehen und ggf. zu vermeiden. Dieser Artikel stellt im Detail dar, welche SQL Statements die Factory des Tabularen Clients generiert und welche Ausführungspläne im SQL Server daraus entstehen. Mit diesen Informationen kann das Laufzeitverhalten eines konkreten problematischen PowerBI Berichts analysiert und optimiert werden.
Der nachfolgende Artikel wird demnächst in einer erweiterten Version auf meinem [Blog](https://blog.n-dimensions.de) veröffentlicht.
1. Navigation TopDown vs. Navigation mittels Paging
Die Verwendung von Berichts-Daten aus Tabularen Modellen läßt sich grob in zwei Kategorieen einteilen:
- Navigation TopDown: ein Bericht zeigt - basierend auf einer grossen Datenmenge - wenige hoch-aggregierte Informationen an (Daten in niedriger Granularität), und stellt eine optionale DrillDown-Möglichkeit zur Verfügung. Auf dem hoch-aggregierten Level können bestimmte Elemente selektiert werden und für diese Elemente können die zu Grunde liegenden Details angezeigt werden. Für diesen Einsatzzweck ist z.B. das Matrix Visual konzipiert.
- Navigation mittels Paging: Anzeige von Daten in hoher Granularität. Durch Scroll-Aktivität auf einem Visual werden successive Chunks von 501 Zeilen abgerufen und angezeigt. Das Tabellen Visual bedient diesen Einsatzzweck.
Je nach Visual werden im Hintergrund hauptsächlich die beiden DAX-Funktionen SUMMARIZE und SUMMARIZECOLUMNS als Beschaffer der Daten aufgerufen. Das Tabellen Visual beispielsweise triggert ein DAX-Statement mit SUMMARIZE, das Matrix Visual eines mit SUMMARIZECOLUMNS. Manchmal werden auch beide Funktionen für ein einzelnes Visual verwendet, so, es wie beim Line Chart Visual der Fall ist.
Aus der Interaktion des Users mit dem Bericht bzw. dem Visual entstehen DAX-Statements, die wiederum in SQL-Statements transformiert werden.
1.1. Navigation TopDown
Im Allgemeinen ist die Verwendung von Daten TopDown im Direct Query Mode unproblematisch, auch, wenn dabei eine sehr grosse Tabelle referenziert wird. Die wenigen Elemente, die initial angezeigt werden, können über effektive Datenbank-Routinen schnell zusammengestellt werden. I.d.R. empfiehlt sich ein CLUSTERED COLUMNSTORE INDEX (CCI) auf der SQL Server Seite. Die Organisation von Tabellen in einem CCI ist genau für den Anwendungsfall des Tabularen Clients gedacht. Ein CCI unterstützt analytische Abfragen, die letztlich darauf hinauslaufen, aus einer gigantischen Datenmenge relativ grosse Subsets zu extrahieren, und diese optional wiederum für Aggregation zu benutzen. Ein CCI erledigt diese Aufgaben in optimaler Art und Weise.
1.2. Navigation mittels Paging
Im nächsten Beispiel wird ein Tabellen Visual verwendet, um die Tabelle [FactSales04] darzustellen. Dieses Mal ruft PowerBI die Daten vom SQL Server in Chunks ab, jeder mit einer Grösse von 501 Zeilen. Die Idee dahinter ist, nicht alle Daten komplett auf einmal zu laden, wobei die Kapazität des Client Arbeitsspeichers überschritten würde, sondern on-demand, wie sie für die aktuelle Operation gerade benötigt werden. Um nach dem initialen Chunk weitere Chunks abzurufen, kann die Extraktion wiederholt werden - mit anderen Parametern, aber wieder mit einer Grösse von 501 Zeilen. Die wiederholte Extrakion wird getriggert durch Scroll-Aktivität im Visual.
Im Großen und Ganzen verursacht die Scroll-Aktivität einen inkrementellen Extraktions-Vorgang auf der Datenbank-Seite. Um einen konsistenten Lese-Prozess zu garantieren, werden die Daten 1. in einer festgelegten Reihenfolge verarbeitet und 2. so, dass die gleiche Zeile nicht mehrfach geladen wird. Dadurch, dass der Tabulare Client im Direct Query Mode die Daten Chunk-für-Chunk verarbeitet, kann sich im Vergleich zum Import Mode ein Vorteil ergeben: der Verbrauch an Zeit und Client Arbeitsspeicher wird auf ein Minimum reduziert.
Die inkrementelle Extraktion on demand entspricht Konzepten, die man in der IT auch aus anderen Bereichen kennt:
- In der Anwendungs-Entwicklung - häufig Web-Anwendungen - kennt man das Konzept von Paging
- In DBMS kennt man Tally Tables, um einen auf Paging basierenden Extraktions-Prozess zu unterstützen
- In der alten ADO-Bibliothek war es möglich, im DBMS eine Kopie oder Referenz der benötigten Datenmenge abholbereit zur Verfügung zu stellen. Dies erledigte auf der Datenbank-Seite ein Cursor. Der Client konnte dann die Daten Batch- oder Zeilen-weise über den Cursor anfordern.
- Andere Pendants finden sich in (Python) Iteratoren oder (C#) Readern.
1.3. Connectionless Paging im Tabularen Client
Die Extraktions-Logik des Tabularen Clients folgt ebenfalls dem Paging-Konzept, basiert aber im Gegensatz zu Iteratoren etc. auf anderen Rahmenbedingungen:
- Der Tabulare Client erwartet nicht grundsätzlich eine relationale Datenquelle, sondern kann die Daten aus verschiedensten Quell-Systemen extrahieren wie z.B. JSON, CSV, REST API etc. Vermutlich folgt Microsoft bei der Vielfalt möglicher Datenquellen den Ansatz, den Extraktions-Prozess möglichst generisch zu gestalten, sich nicht auf die unterschiedlichen Fähigkeiten der Quell-Systeme zu verlassen und die Business Logik der Extraktion ausschliesslich mit Hilfe der Client Features zu implementieren.
- Daten könnten zwar in einem DBMS bereitgestellt sein, aber die Bereitstellung könnte nicht-compliant zu gängigen Verfahren sein: Beispielsweise könnten die Daten in Tabellen ohne Primär-Schlüssel residieren. Trotzdem muss der Extraktions-Prozess auch diese Daten inkrementell behandeln können.
- Das Extraktions-Pattern ist nicht nur Client-zentriert, sondern auch connectionless. Es arbeitet also ohne dauerhafte Verbindung zwischen Client und DBMS. Eine verbindungslose Kommunikation zwischen Client und Datenbank-Server ist seit ADO.NET der Standard und ist für Azure-basierte Prozesse, heterogene Umgebungen etc. gut geeignet.
Aus den Rahmenbedingungen des Tabularen Clients ergibt sich ein technischer Vorteil zu Gunsten der Iteratoren etc: sie alle warten an der letzten Position auf einen Command zur Fortsetzung, eine Art Resume-Funktionalität. Dadurch entfällt der Aufwand, beim nächsten Call die Position für die Fortsetzung zu finden. Der Tabulare Client jedoch implementiert die inkrementelle Extraktion ausschliesslich mit Hilfe seiner eigenen Features und kann an keine Instanz einen Resume-Command senden. Beim Fortsetzen der Extraktion bzw. dem Abrufen des nächsten Chunks entsteht die technische Problematik, den Chunk in einem potentiell riesigem Haufen ohne Verzug zu finden. Im Best Case setzt der Tabulare Client ein Statement ab, dass von SQL Server als SEEK im CLUSTERED INDEX kompiliert wird. Dann kann der Chunk gezielt aus dem grossen Haufen gepickt werden. Im Worst Case generiert SQL Server einen Ausführungsplan mit FULL TABLE SCAN und ein kleiner Chunk von 501 Zeilen muss aus der potentiell riesigen Menge herausgefiltert werden. Damit nicht genug würde sich der problematische TABLE SCAN auch noch für jeden Chunk wiederholen!
2. SQL Statement für Paging
Die Factory des Tabularen Clients generiert Statements, die folgendes enthalten:
GROUP BY unterdrückt Duplikate und kommt beim Tabularen Client in folgenden Fällen zum Zuge: Duplikate durch Datenfehler, Mögliche Duplikate durch fehlenden Primär-Schlüssel, Aufruf der Tabelle in einer niedrigeren Granularität (PK-Spalte wird nicht im Visual verwendet)
ORDER BY sorgt für Sortierung und stellt die Voraussetzung für das Paging bereit. Mit WHERE und TOP wird die Sortierung genutzt
WHERE: Innerhalb der sortierten Datenmenge kann der Start des aktuellen Chunks identifiziert werden
TOP: Innerhalb der sortierten Datenmenge kann das Ende des aktuellen Chunks identifiziert werden
2.1. Ablauf des Paging
Die inkrementelle Extraktion läuft in 3 Schritten ab:
- Das Tabellen-Schema wird abgerufen
- Der erste Chunk wird abgerufen. Der erste Chunk endet bei Zeile 501 der sortierten Datenmenge
- Basierend auf der Sortierung wird on-demand der nächste Chunk abgerufen. Der nächste Chunk umfasst alle Zeilen, die größer oder gleich sind als die vorletzte Zeile des vorherigen Chunks [1]. Das Ende des Chunks ist nach 501 Zeilen erreicht. Schritt 3 kann wiederholt werden.
2.2. Beispiel: Abruf von Chunk 2
Im Visual werden die folgenden Spalten aufgerufen:
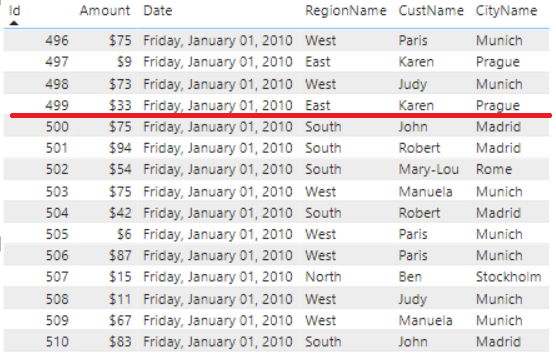
Das dazugehorige Trace für den zweiten Chunk (Id > 500):
SELECT TOP (501)
    [t7].[Id],
    [t7].[Date],
    [t7].[CustName],
    [t7].[CityName],
    [t7].[RegionName],
    [t7].[Amount]
FROM
(
    (select
         -- Alle physischen Spalten:
         [$Table].[Id] as [Id],
         [$Table].[TimeId] as [TimeId],
         [$Table].[Date] as [Date],
         [$Table].[CustId] as [CustId],
         [$Table].[CustName] as [CustName],
         [$Table].[CityName] as [CityName],
         [$Table].[RegionName] as [RegionName],
         [$Table].[ProdName] as [ProdName],
         [$Table].[Category] as [Category],
         [$Table].[Amount] as [Amount]
     from [dbo].[FactSales04] as [$Table])
) AS [t7]
WHERE (
          ([t7].[Id] > 500)
          OR (
                 ([t7].[Id] = 500)
                 AND (
                         ([t7].[Date] > CAST('20100101 00:00:00' AS datetime))
                         OR (
                                ([t7].[Date] = CAST('20100101 00:00:00' AS datetime))
                                AND (
                                        ([t7].[RegionName] > N'South')
                                        OR (
                                               ([t7].[RegionName] = N'South')
                                               AND (
                                                       ([t7].[CityName] > N'Madrid')
                                                       OR (
                                                              ([t7].[CityName] = N'Madrid')
                                                              AND (
                                                                      ([t7].[CustName] > N'John')
                                                                      OR (
                                                                             ([t7].[CustName] = N'John')
                                                                             AND ([t7].[Amount] >= CAST(N'75' AS money))
                                                                         )
                                                                  )
                                                          )
                                                   )
                                           )
                                    )
                            )
                     )
             )
      )
GROUP BY
    -- Visual: selektierte Spalten
    [t7].[Id],
    [t7].[Date],
    [t7].[CustName],
    [t7].[CityName],
    [t7].[RegionName],
    [t7].[Amount]
ORDER BY
    -- Visual: selektierte Spalten
    [t7].[Id],
    [t7].[Date],
    [t7].[RegionName],
    [t7].[CityName],
    [t7].[CustName],
    [t7].[Amount];
2.2.1. Statement Komponente SELECT und TOP
Die Reihenfolge der Spalten im SELECT entspricht nicht der Reihenfolge im Visual, spielt aber aus Performance-Sicht keine Rolle. Mit TOP wird das Ende des Chunks ermittelt.
2.2.2. Statement Komponente FROM
Im inneren SELECT ... FROM wird die vollständige Tabelle inklusive aller Spalten aufgerufen, auch, wenn z.B. das Visual nur 2 Spalten anfordert. Zum Glück führt die Factory auch ein Rewrite durch und entfernt im äußeren SELECT die nicht benötigten Spalten. Dies wird vom Optimierer zur Kenntnis genommen und führt zu einer entsprechenden Einschränkung der Spaltenliste. Die Einschränkung macht sich beim CLUSTERED INDEX, der ja als Row Store organisiert ist, nicht als Verbesserung beim IO bemerkbar. Jedoch ergibt sich bei einer Organisation der Tabelle als COLUMNSTORE INDEX ein Vorteil: je weniger Spalten im Visual ausgewählt werden, desto schneller kann die Abfrage bedient werden.
2.2.2. Statement Komponente WHERE
Die Komplexität der WHERE-Klausel mit ihren vielen ineinander verschachtelten Conditions ergibt sich aus dem Pattern, mit dem das Offset des aktuellen Chunks ermittelt wird: die Werte 500, South etc. entsprechen der letzten Zeile des vorherigen Chunks. Durch Sortierung und verschachtelte Conditions ergibt sich, dass die WHERE-Klausel auf alle Zeilen einschränkt, die größer als die letzte Zeile des vorherigen Chunks sind. Dass tatsächlich nicht alle Zeilen ab diesem Punkt zurückgegeben werden, liegt daran, dass die TOP-Klausel die Rückgabe nach 501 Zeilen abbricht.
Die Komplexität der WHERE-Klausel würde sich steigern, wenn im Modell des Tabularen Clients NULL-Zulässigkeit aktiviert wäre. Im konkreten Beispiel oben würde sich der Plan nicht ändern, aber die zusätzliche Komplexität könnte unter anderen Umständen zu einem anderen Plan mit negativen Impact auf die Performance führen.
2.2.3. Statement Komponente GROUP BY
Die Distinct-Bildung mittels GROUP BY wird dem Statement hinzugefügt, um im Endeffekt immer dafür zu sorgen, dass die an den Tabularen Client zurückgelieferten Daten nur eindeutige Zeilen enthalten. Duplikate könnten in folgenden Fällen entstehen:
- Ungewollte Duplikate als Fehler in den Daten
- Duplikate, die aus formalen Gründen (fehlender Primärschlüssel) denkbar sind
- Explizite Reduktion von Duplikaten in den Fällen, wo weder die Spalte mit dem Primärschlüssel, noch eine andere Spalte mit eindeutigen Werten im SELECT aufgeführt ist
2.2.4. Statement Komponente ORDER BY
Die Sortierung ermöglicht das Paging und wird gesteuert durch die Reihenfolge, in der die Spalten im Visual ausgewählt werden. Hierbei ist höchste Vorsicht geboten: Die Optimierungsmöglichkeiten auf Seiten von SQL Server hängen wesentlich von Sortierungen ab. Im CLUSTERED INDEX ist die ganze Tabelle sortiert - i.d.R. nach dem Primärschlüssel. Für die Verwendung des CLUSTERED INDEX im Rahmen eines SEEKs wäre es daher entscheidend, dass die [Id]-Spalte als erstes Kriterium im ORDER BY genannt wird. Dies ergibt sich durch DragAndDrop der [Id]-Spalte im Visual - oder sicherer noch durch explizites Sortieren im Visual.
Aber auch im CLUSTERED COLUMNSTORE INDEX (CCI) können die Daten sortiert sein. Ist der CCI beispielsweise nach der Spalte [Id] sortiert, könnte die Verwendung der Spalte [Id] im Visual zu Segment Eliminierung[2] beitragen. Hierbei würde es im Gegensatz zum CLUSTERED INDEX keine Rolle spielen, an welcher Position in der Spaltenliste das Sortierkriterium des CCI auftaucht.
3. Ausführungs-Varianten, die SQL Server auf Grund der Tabellen-Physik anbietet
Ausgangspunkt für die Analyse ist die Physik der Tabelle: sie kann entweder als CLUSTERED INDEX, als CLUSTERED COLUMNSTORE INDEX oder als HEAP organisiert sein. Für alle drei Fälle werden mögliche Ausführungs-Varianten durchdacht. Die schlechteste Ausführungs-Varianten ist für alle Physiken ein SCAN. Mit Hilfe des SCANS kann jede Query ausgeführt werden und - weil dies eine Selbstverständlichkeit ist - wird dieser schlechteste Fall nicht analysiert. Bitte beachten Sie, dass die schlechte Performance des SCANS sich noch weiter verschlechtern kann, wenn sich HASH oder SORT daran anschliessen.
3.1. Szenario 1: Tabelle [FactSales04] als CLUSTERED INDEX
In Szenario 1 ist die Tabelle [FactSales04] als CLUSTERED INDEX organisiert.

Aus den Meta-Daten geht hervor, dass der B-Tree aus drei Levels besteht. 12,215,901 Zeilen werden auf 181,763 Pages gespeichert. Im Schnitt speichert also jede einzelne Page 67.2 Zeilen. Um einen einzelnen Chunk mit seinen 501 Zeilen zu extrahieren, müssen auf dem Leaf-Level im Schnitt 8 Pages gelesen werden.
Zum Aufwand für das Lesen des Chunks kommt der Aufwand hinzu, das Offset für den Start des Chunks zu identifizieren.
3.1.1. Variante 1 - SEEK
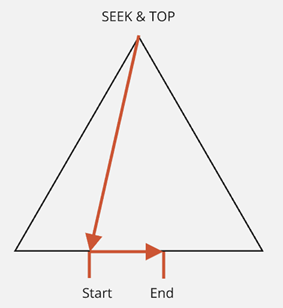
Der B-Tree muss traversiert werden, um zur Start-Page des Chunks zu gelangen. Da die erste Leaf-Level Page bereits im Aufwand von 8 IOs berücksichtigt wurde, kommen durch die Traversierung des aus drei Levels bestehenden B-Trees noch 2 Pages zusätzlich hinzu. Insgesamt verursacht also das Lesen eines Chunks im Rahmen einer SEEK-Operation einen Gesamtaufwand von konstant 10 IOs - also unabhängig von der Frage, wo sich das Offset des Chunks befindet.
3.1.2. Variante 2 - SCAN und TOP
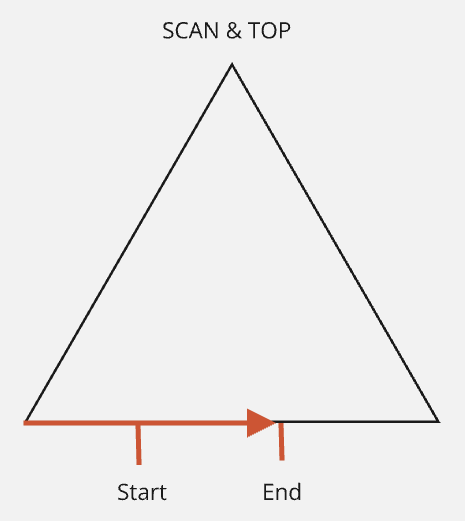
Der Start des Chunks kann durch einen SCAN in Sortier-Reihenfolge erreicht werden. Es wird die erste Page des CLUSTERD INDEXES gelesen, dann die zweite, etc. bis der Start des Chunks erreicht wird. Wenn - ebenfalls im Rahmen des SCANs - alle Pages des Chunks gelesen wurden, kann die Operation abgebrochen werden.
Der Aufwand von Variante 2 hängt von der Frage ab, wo sich der Start des Chunks befindet. Der Start kann zwischen der ersten Page des Leaf-Levels und der (fast) letzten Page liegen. Daraus ergibt sich ein Aufwand zwischen 8 und 182,138 IOs. Für Chunks nahe dem Start ist der Aufwand ähnlich wie der für einen SEEK, also ca. 20 IOs. Für Chunks nahe dem Ende ist der Aufwand ähnlich wie der für einen SCAN, also gegen 182,146 IOs.
3.2. Szenario 2: Tabelle [FactSales04] als ORDERED CLUSTERED COLUMNSTORE INDEX (CCI)
In Szenario 2 ist die Tabelle [FactSales04] als CLUSTERED COLUMNSTORE INDEX mit dem Namen [ixFactSales04] organisiert. Des Weiteren wurde die Spalte [Id] als Sortierkriterium verwendet:
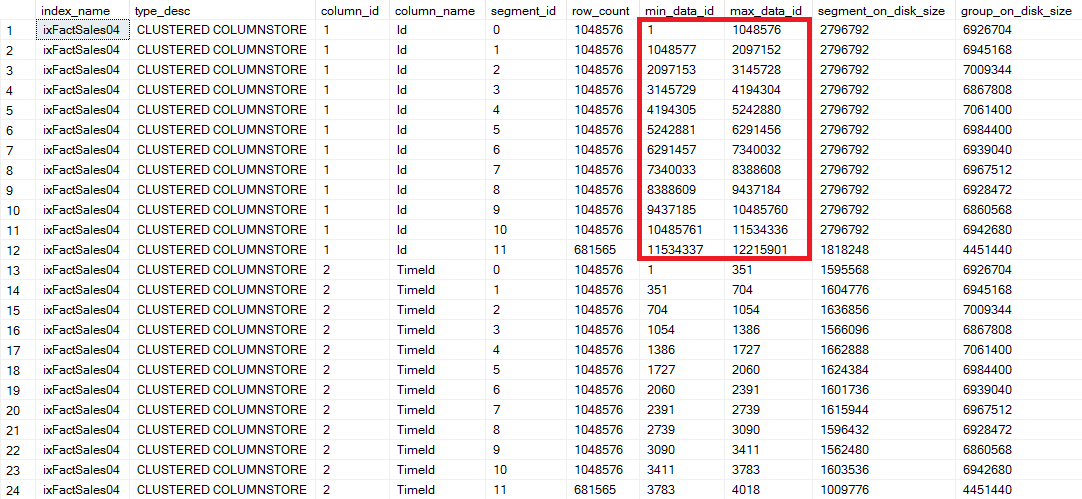
In der Umrahmung (rotes Kästchen im Screenshot) wird hervorgehoben, dass die Segmente für die Spalte [Id] in Sortier-Reihenfolge gefüllt wurden:
- [Id]-Range für Segment 1: 1 bis 1048576
- [Id]-Range für Segment 2: 1048577 bis 2097152
- etc.
Bei der Füllung der Segmente für die [TimeId]-Spalte wurde keine explizite Sortierung angegeben. Dass die Daten in der [TimeId]-Spalte aber effektiv ebenfalls sortiert sind, liegt daran, dass der Prozess zum Erstellen der Segmente die Daten in Reihenfolge der [Id]-Spalte liest, wobei [Id]-Reihenfolge und [TimeId]-Reihenfolge korrelieren. Das gleiche trifft auf die Spalte [Date] zu. Die Segmente für die anderen Spalten sind dagegen willkürlich gefüllt, da es keinen fachlichen Zusammenhang zwischen z.B. [Id] und [RegionName] gibt.
Die Spalten [Id], [TimeId] und [Date] eignen sich auf Grund ihrer Sortierung für Zeilengruppen-Eliminierung.
3.2.1. Variante 3 - CCI mit Segment-Eliminierung
Ein einzelner Chunk mit seinen 501 Zeilen benötigt nur wenig Platz. Ein Chunk kann in den Segmenten einer einzelnen Zeilengruppe untergebracht werden, pro Spalte ein Segment. Die restlichen Zeilengruppen und Segmente können eliminiert werden. Der beste Fall für Pagig im CCI ist daher unter folgenden Umständen gegeben:
- Einschränkung in der WHERE-Klausel auf eine Zeilengruppe mit Hilfe der [Id]-, [TimeId]- oder [Date]-Spalte. Dies reduziert die gelesenen Zeilengruppen auf eine einzelne
- Selektion weniger Spalten wie z.B. 3. Dies reduziert die gelesenen Segmente auf 3.
- FILTER-Conditions in der WHERE-Klausel, die in den CCI-SCAN-Operator als Predicate gepusht werden. Dies verringert nicht den IO, sorgt aber dafür, dass die FILTER-Operation Ressourcen-schonend ausgeführt wird
3.3. Szenario 3: Tabelle [FactSales04] als HEAP mit UNIQUE NONCLUSTERED INDEX
Als letzte Variation, die Tabelle [FactSales04] physisch zu organisieren, bleibt ein HEAP. Der Primärschlüssel ist als UNIQUE NONCLUSTERED INDEX implementiert.
Im Optimalfall kann diese Physik ähnlich funktionieren wie Variante 2 (SCAN mit TOP): Die Sortierung gibt in diesem Fall nicht der CLUSTERED INDEX vor, sondern der NONCLUSTERED INDEX. Die Liste der Ids wird sortiert aus dem NONCLUSTERED INDEX abgerufen. Im Rahmen jedes einzelnen LOOKUPs wird dann die Predicate-Expression (die im WHERE aufgeführten Conditions) untersucht. Jeder Pointer des NONCLUSTERED INDEX wird für einen LOOKUP verwendet, wodurch ein IO entsteht. Da Chunk 2 an Zeile 501 beginnt, werden bis zum Erreichen des Offsets 501 IOs im HEAP ausgeführt. Danach wird der Scope des Chunks iterativ eingelesen, was wiederum 501 IOs im HEAP nach sich zieht. Danach bricht der TOP-Operator die Iteration ab. Wie in den Varianten 1 und 2 zeigt sich, dass die Position des Offsets einen variablen Aufwand bedingt, der gering sein kann, wenn sich das Offset am Anfang befindet und einen grossen Aufwand, wenn sich das Offset am Ende befindet. Die Effektivität der Physik ist mit zunehmender Verschiebung im NONCLUSTERED INDEX nach hinten deutlich geringer als in Variante 1 und 2. Beim CLUSTERED INDEX wird ein einzelner IO fällig, um 67 Zeilen zu lesen, beim NONCLUSTERED INDEX werden 67 IOs für 67 Zeilen fällig - also der 67-fach größere Aufwand. Zudem entsteht beim SCAN im CLUSTERED INDEX ein Sequential IO, während die Iteration im NONCLUSTERED INDEX einen iterativen Random IO verursacht - ein weiterer Nachteil im Vergleich zu den Varianten 1 und 2.
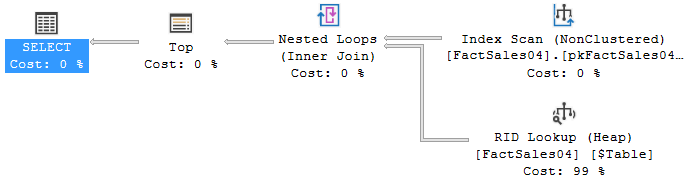
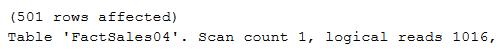
Da Chunk 2 sich am Anfang befindet, benötigt die Abfrage nur 1016 IOs und ist dementsprechend performant:
4. Ausführungs-Varianten, die durch die Factory zustande kommen können
4.1. Check von Variante 1 - SEEK im CLUSTERED INDEX
In diesem Abschnitt wird das Zusammenspiel von Factory und Variante 1 - SEEK untersucht. Von den drei Varianten ist die SEEK-Variante mit ca. 10 IOs die beste.
Beispiel. Zugriff auf Chunk 2:
select top 501
	*
from FactSales04
where id > 500
order by id;
Der Plan dazu:
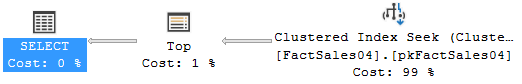
Durch die Expression id > 500 in der WHERE-Klausel wäre die Voraussetzung für den SEEK erfüllt. Das Trace für Chunk 2 zeigt, dass die Factory tatsächlich eine WHERE-Klausel mit id > 500 generiert hat. Leider aber hat die Factory noch weitere verschachtelte Conditions hinzugefügt, alle mit einem OR an die vorherige Condition anschliessend.
Inhaltlich betrachtet ist der wesentliche Teil aller Conditions der WHERE-Klausel die Filter-Expression id > 500. Mit einer WHERE-Klausel bestehend aus dieser einen Condition, dem CLUSTERED INDEX, mit Hilfe von Primär-Schlüssel und TOP wäre es möglich, lückenlos dem vorherigen Chunk folgend alle weiteren Zeilen in Sortierreihenfolge zu extrahieren. Die Existenz weiterer Filter-Expressions wäre also aus Sicht der Datenbank überflüssig. Dass die Factory der WHERE-Klausel trotzdem noch weitere Conditions hinzufügt, hat einen Grund, der vermutlich der selbe ist wie für die Statement Komponente GROUP BY.
Leider verursacht die Existenz des OR-Operators aus formalen Gründen einen SCAN. Dies läßt sich an einem reduzierten Beispiel schnell durchdenken:
...
where id = 100 or RegionName = N'West'
West kann an jeder Stelle des Leaf-Levels auftreten, nicht erst nach id 100. Auch, wenn eine gegenseitige Abhängigkeit von Parameter-Werten existieren kann und ev. statistisch erfasst wird, sind Parameter-Werte grundsätzlich voneinander unabhängig. Daher kommt der Optimierer zwangsläufig zu einem SCAN. Diese Formalie führt auch zur Ablehnung eines FORCESEEK. Durch geschickte Kombination verschiedener NONCLUSTERED INDIZES oder der Verwendung von INCLUDE könnte man die Restriktion zwar umgehen, allerdings wäre die jeweiligen Konstruktion ein massgeschneiderter Workaround für eine ganz spezielle Spalten-Kombination und würde keine allgemeine Lösung für das OR-Problem darstellen.
4.2. Check von Variante 2 - SCAN und TOP im CLUSTERED INDEX
Der zweitbeste Plan ist ein SCAN mit Abbruch durch TOP. Der TOP-Operator muss direkt nach dem SCAN erfolgen, um den SCAN so früh wie möglich zu beenden. Er macht den Unterschied aus zwischen einem Leseprozess, der sich bis zum aktuellen Chunk durchscrollt oder einem SCAN, der alle 182,138 Pages erfasst. Falls im Plan hinter dem TOP noch weitere aufwändige Operatoren wie SORT und HASH folgen sollten, würden diese mit einer minimalen Datenmenge von 501 Zeilen bedient statt mit allen 12,215,901 Zeilen der Tabelle. Die frühestmögliche Einschränkung der Zeilen kann zudem Spilling vermeiden.
Die Variante eines SCANS mit TOP funktioniert nur unter bestimmten Bedingungen. Wesentlich ist, dass das erste Kriterium des ORDER BY dem Sortierkriterium des CLUSTERED INDEX entspricht. Im Beispiel bedeutet dies: die erste Spalte im Visual muss [Id] sein, weil der CLUSTERED INDEX nach [Id] sortiert ist. Falls diese Voraussetzug erfüllt ist, können die Daten des SCANS in Sortier-Reihenfolge direkt dem TOP-Operator angeboten werden. Eine Art Nachsortierung nach weiteren Kriterien des ORDER BY wie [Date], [RegionName], [CityName] etc. entfällt. Aus der Primärschlüssel-Eigenschaft ergibt sich, dass jede [Id]-Gruppe nur ein einziges Element enthält.
Während Variante 1 (SEEK) mit der besten Laufzeit aus formalen Gründen nicht zum Einsatz kommen kann, kompiliert SQL Server das Statement aus dem Trace oben (Abruf von Chunk 2 im CLUSTERED INDEX) mit Variante 2 (SCAN und TOP) als der zweitbesten Variante:
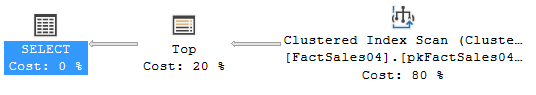
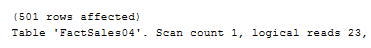
Da Chunk 2 noch nahe am Beginn des CLUSTERED INDEX liegt, ergibt sich eine IO-Statistik, die fast genauso gut ist wie die von Variante 1:
4.3. Check von Variante 3 - Segment Eliminierung im CLUSTERED COLUMNSTORE INDEX
Ein Fall, in dem man den CCI explizit zur Untersützung für Paging einsetzt, wäre ein untypischer Fall. Ein CCI ist eher für die Fälle konzipiert, in denen es darum geht, aus einer gigantischen Datenmenge einen recht grossen Anteil zu extrahieren. Der CCI soll grundsätzlich einen SCAN durchführen und diese Aufgabe möglichst performant erledigen. Wenn aus der grossen Datenmenge nur ein kleiner Chunk extrahiert werden soll, ist ein CCI dafür eigenlich das falsche Mittel. Für selektiven Zugriff wären die klassischen RowStore-Indizes besser geeignet. Wir gehen an dieser Stelle davon aus, dass ein CCI auf Grund seiner besonderen Eignung für die analytischen Abfragen des Tabularen Clients eingesetzt werden soll - also für die Fälle, die nichts mit dem Paging zu tun haben -, und fragen uns, wie unter dieser Voraussetzug CCI und Paging interagieren.
Das Hauptziel ist, die durch den CCI zurückgegebene Datenmenge möglichst effektiv einzuschränken. Der Optimalfall wird erreicht, wenn der CCI sortiert ist, das Sortier-Kriterium des CCIs als Spalte im Visual verwendet wird, im Visual wenige Tabellen-Spalten ausgewählt werden und alle weiteren Filter-Bedingungen in den CCI als Prädikat gepusht werden können.
Hypotethischer Best Case: Paging mit BETWEEN:
Wir gehen von einem hypothetischen Best Case aus, in dem aus Chunk 2 nur die [Id]-Spalte selektiert wird:
select
	id
from FactSales04
where id between 501 and 1000
order by id;
Der Plan sieht wie folgt aus:
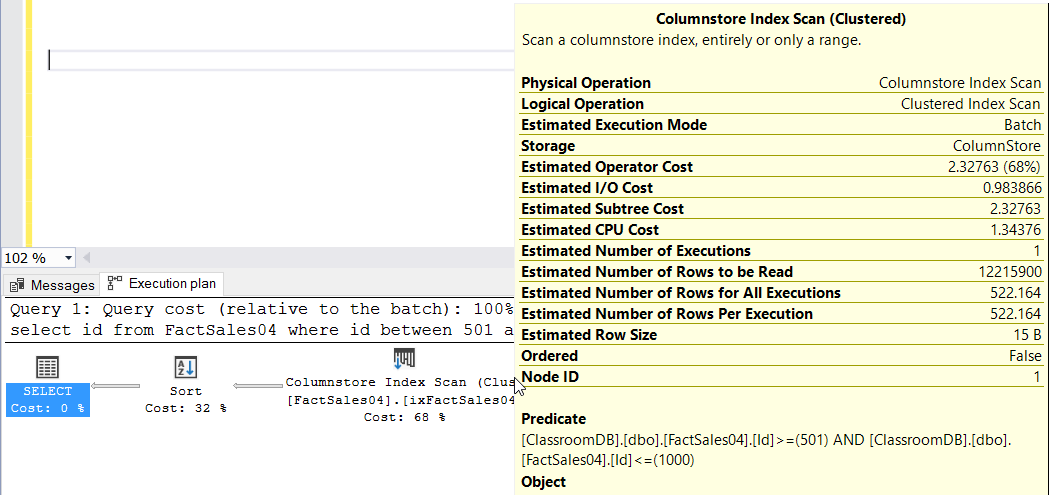
Dabei wird 1 Segment gelesen und 11 ausgelassen. Der IO-Aufwand beträgt 343. Der IO-Aufwand kann mit Hilfe der Meta-Daten nachvollzogen werden: die in der WHERE-Klausel abgerufene Range kann allein mit Segment 0 für Spalte 1 bedient werden. Die Bytegrösse für das Segment beträgt 2796792, was einer Größe von 2731.2 KiloByte entspricht. Da eine einzelne Datenbank-Page ein Volumen von 8 KiloBytes umfasst, werden 341.4 IOs benötigt, um das eine Segment zu lesen. Bitte beachten Sie, dass die Range-Definition des Chunks in eine Predicate Expression des SCANs gewandert ist und nicht durch einen späteren FILTER durchgesetzt wird. Dies zieht eine gute Performance nach sich.
Paging mit TOP:
Das SELECT aus dem theoretischen Best Case von oben entspricht in einem wesentlichen Punkt nicht dem von der Factory tatsächlich generierten: der Chunk wird nicht mit BETWEEN ermittelt, sondern mit einer Kombination aus id > 500, TOP 501 und ORDER BY. Eine vereinfachte Variante für Chunk 2, die diese Kombination berücksichtigt, aber ohne die weiteren Argumente der WHERE-Klausel auskommt, sieht dann so aus:
select top 501
	id
from FactSales04
where id > 501
order by id;
Der Plan dazu:

Dieses Mal ruft SQL Server - über alle Zeilengruppen hinweg - alle Segmente der Spalte [Id] ab. Dies verursacht laut Statistik einen IO von 3996. Eine Gegenprüfung der Physik ergibt, dass das Volumen von 2796792 Bytes aller Segmente der [Id]-Spalte in KiloBytes umgerechnet und durch 8 KiloBytes dividiert eine IO Anzahl von 3977.4 nach sich zieht. Dass das Gesamt-Volumen des CCI von ca. 81 MB nicht komplett gelesen wird, liegt daran, dass nur die [Id]-Spalte aufgerufen wurde. Mit jeder weiteren Spalte müssen mehr Segmente gelesen werden und beim * ist das Maximum erreicht.
Der Plan oben ist alles andere als gut: die Filter-Condition id > 501 wäre besser im SCAN als Prädikat untergebracht. Zudem kann der TOP-Operator nur auf der sortierten Menge arbeiten, daher muss die komplette Spalte [Id] vor dem TOP-Operator durchsortiert werden. Wenn im Live-Betrieb durch Benutzer-Aktivität viele oder sogar alle Spalten der Tabelle verwendet werden, bedeutet dieser Plan nicht nur einen SCAN des gesamten Volumens von ca. 81 MB, sondern auch noch ein anschliessendes SORT der gesamten Tabelle - ein erheblicher Aufwand, um am Schluss nur 501 Zeilen zu erhalten.
4.4. Check von Variante 4 - HEAP mit UNIQUE NONCLUSTERED INDEX
Der Plan für HEAP mit UNIQUE NONCLUSTERED INDEX zeigt die relative Effektivität von Variante 4. Sie gründet sich auf zwei Umständen:
- Die vom Visual verlangte Sortierung nach der [Id]-Spalte kann vom NONCLUSTERED INDEX bedient werden
- Die Gruppierung nach [Id], [TimeId] etc. zieht keinen oder HASH- oder SORT-Operator nach sich. Pro [Id] kann es auf Grund der Uniqueness nur einen Gruppen-Member geben.
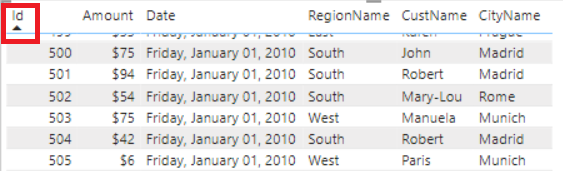
Sobald die [Id]-Spalte aus dem Visual entfernt wird oder durch die internen Verhaltensweisen des Tabularen Clients eine andere Sortierung vorgegeben wird, bei der die [Id]-Spalte nicht als erste im ORDER BY benannt wird, entfällt dieser Vorteil. Es kommt dann zu einem aufwändigen Plan mit Table Scan, Sort etc.:

Die Reihenfolge der Sortier-Kriterien kann nur durch explizites Sortieren im Visual aufrecht erhalten werden:
5. Empfehlung
Die Kombination von Tabularem Modell und Direct Query kann im Allgemeinen auf der SQL Server Seite gut durch einen CCI bedient werden. Für den Spezialfall des Pagings eignen sich u.U. CLUSTERED INDEX oder HEAP in Kombination mit NONCLUSTERED INDEX besser. Die beste Wahl ist dabei der CLUSTERED INDEX. Der Vorteil des CLUSTERED INDEX ist an einige Bedingungen geknüpft:
- Die Verwendung der Berichts-Daten beruht hauptsächlich auf Paging-Aktivität wie z.B. Scroll-Aktivität in grossen Listen
- Im Visual wird die Primärschlüssel-Spalte als erste verwendet
- Im Datenmodell des Tabularen Clients wird die Primärschlüssel-Spalte als Spalte mit eindeutigen Werten konfiguriert
Sonstige allgemeine Empfehlungen:
- Null-Fähigkeit deaktivieren (geringere Komplexität der Statements)
- Referentielle Integrität von Relationships aktivieren
- M:N Relationships vermeiden